도파민의 두 얼굴 — 중독은 의지박약이 아니라 학습의 납치다
쾌락 물질이라는 착각을 걷어내면, 중독의 풍경이 완전히 달라진다
도파민은 쾌락이 아니라 '예측과 갈망'의 신호다. 원숭이 실험에서 시작된 보상예측오차 이야기를 따라가면, 중독은 의지의 문제가 아니라 뇌가 너무 잘 배운 학습의 문제임이 드러난다. '도파민 디톡스'와 행동중독 논쟁까지 통념을 하나씩 걷어낸다.
목이 마른 원숭이 앞에 불빛이 켜지고, 잠시 뒤 관을 타고 단 주스 한 방울이 흘러든다 — 이 단순한 장면 속에서, 도파민에 대한 우리의 상식은 통째로 무너졌다.
1990년대, 신경과학자 볼프람 슐츠(Wolfram Schultz)는 원숭이 뇌 속 도파민 뉴런 하나하나에 미세전극을 꽂고 그 전기 신호를 듣고 있었다. 당시의 교과서적 상식은 명료했다. 도파민은 쾌락의 물질이다. 좋은 일이 생기면 분비되고, 그 분비가 곧 기쁨이다. 주스가 혀에 닿는 순간 뉴런이 불꽃처럼 터질 것이라고, 누구나 예상했다.
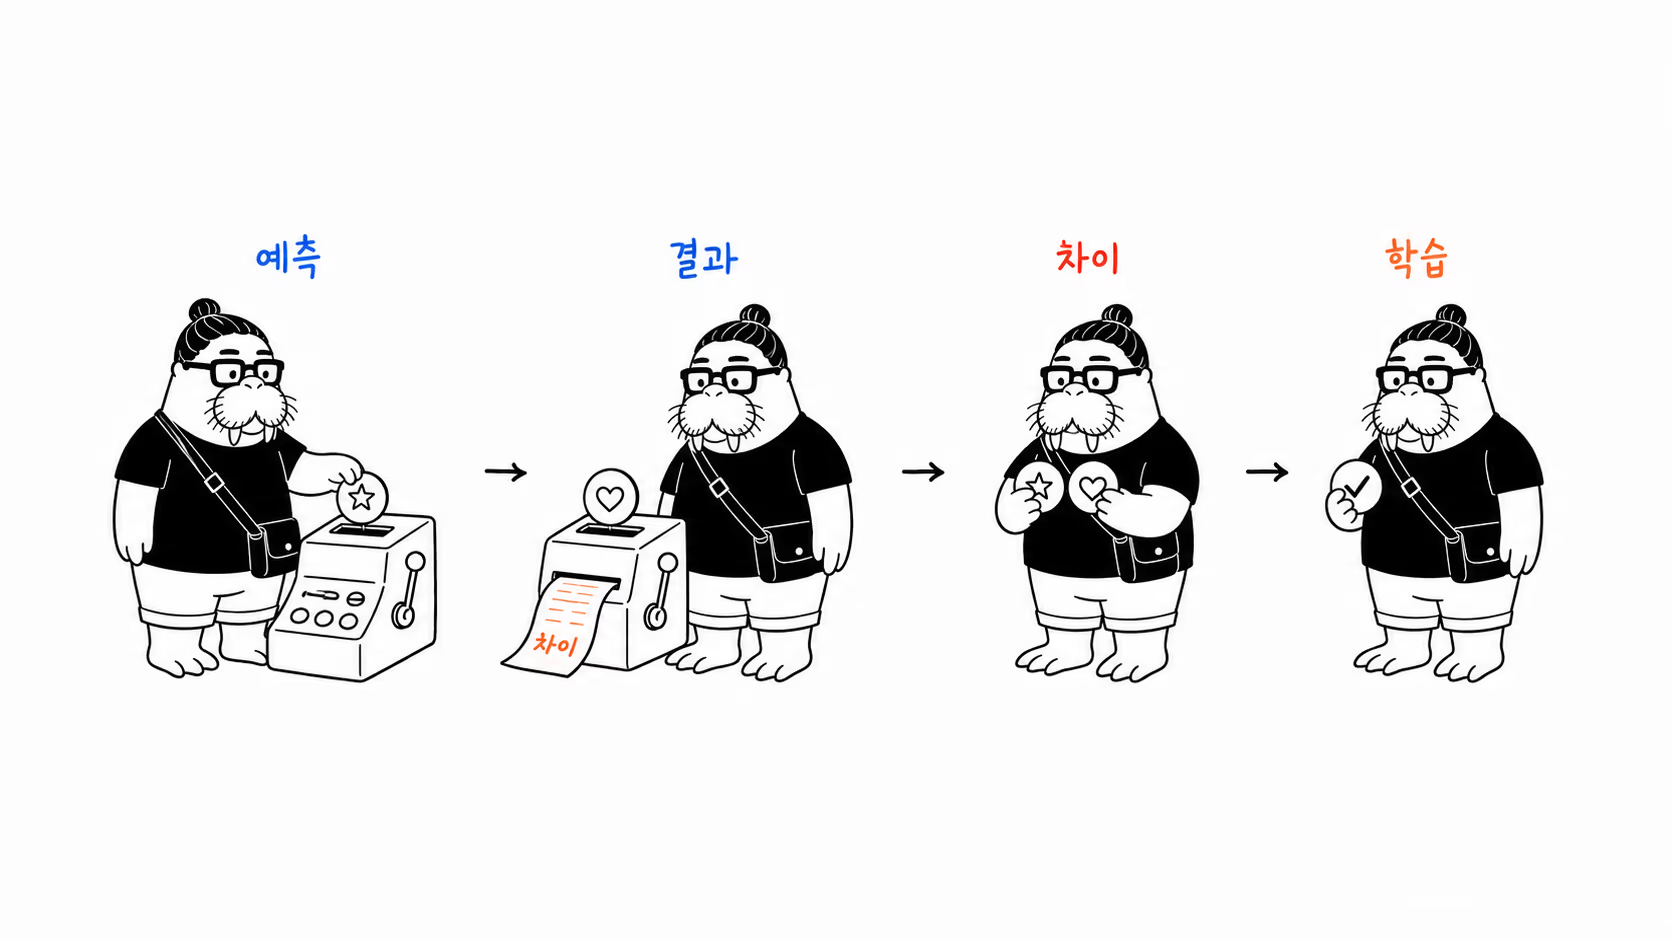
처음엔 그랬다. 예고 없이 주스가 주어지면 도파민 뉴런은 격렬하게 발화했다. 그런데 원숭이가 학습을 하기 시작하자 신호가 이상하게 움직였다. 불빛이 켜진 뒤에 주스가 온다는 규칙을 원숭이가 터득하자, 도파민의 폭발은 주스가 도착하는 순간에서 불빛이 켜지는 순간으로 앞당겨졌다. 정작 주스가 입에 들어올 때 뉴런은 조용했다. 그리고 불빛이 켜졌는데 약속된 주스가 오지 않으면, 도파민은 기준선 아래로 뚝 떨어졌다. 마치 실망한 것처럼.
도파민은 쾌락이 아니라 '예측 오차'다
슐츠가 목격한 것은 쾌락의 신호가 아니었다. 그것은 예측이 빗나간 정도를 계산하는 신호, 이른바 **보상예측오차(reward prediction error)**였다. 기대보다 좋은 일이 생기면 도파민이 치솟고(양의 오차), 예상한 그대로면 잠잠하며(오차 없음), 기대에 못 미치면 가라앉는다(음의 오차). 1997년 슐츠는 피터 다얀, 리드 몬터규와 함께 이 원리를 『사이언스』에 정식화했고, 이는 훗날 인공지능의 강화학습 알고리즘과 소름 돋게 닮았다는 사실이 밝혀진다.
핵심은 이것이다. 도파민은 '지금 이것이 얼마나 좋은가'를 재는 물질이 아니라, '다음에 무엇이 올지, 그리고 그 예측이 맞았는지'를 갱신하는 학습 신호다. 도파민은 미식가가 아니라 회계사에 가깝다. 좋은 음식을 즐기라고 있는 게 아니라, 무엇이 좋은 음식을 예고하는지를 장부에 적어두라고 있는 것이다.
흥미롭게도 이 원리는 뇌 밖에서도 확인된다. 오늘날 알파고 같은 인공지능을 학습시키는 강화학습 알고리즘의 핵심이 바로 예측 오차다. 기계는 자신의 예상과 실제 결과의 차이를 계산하고, 그 오차를 줄이는 방향으로 행동을 조금씩 수정하며 배운다. 뇌의 도파민 뉴런이 수백만 년 전부터 해오던 계산을, 우리는 최근에야 코드로 다시 발명한 셈이다.
이 교정이 왜 중요한가. '도파민=쾌락'이라는 통념 위에서는 중독이 그저 '너무 큰 쾌락에 빠진 상태'로 보인다. 하지만 도파민이 학습 신호라면, 중독은 쾌락의 문제가 아니라 학습의 문제가 된다. 뇌가 너무 잘 배워버린 결과.
갈망과 좋아함은 다른 회로다
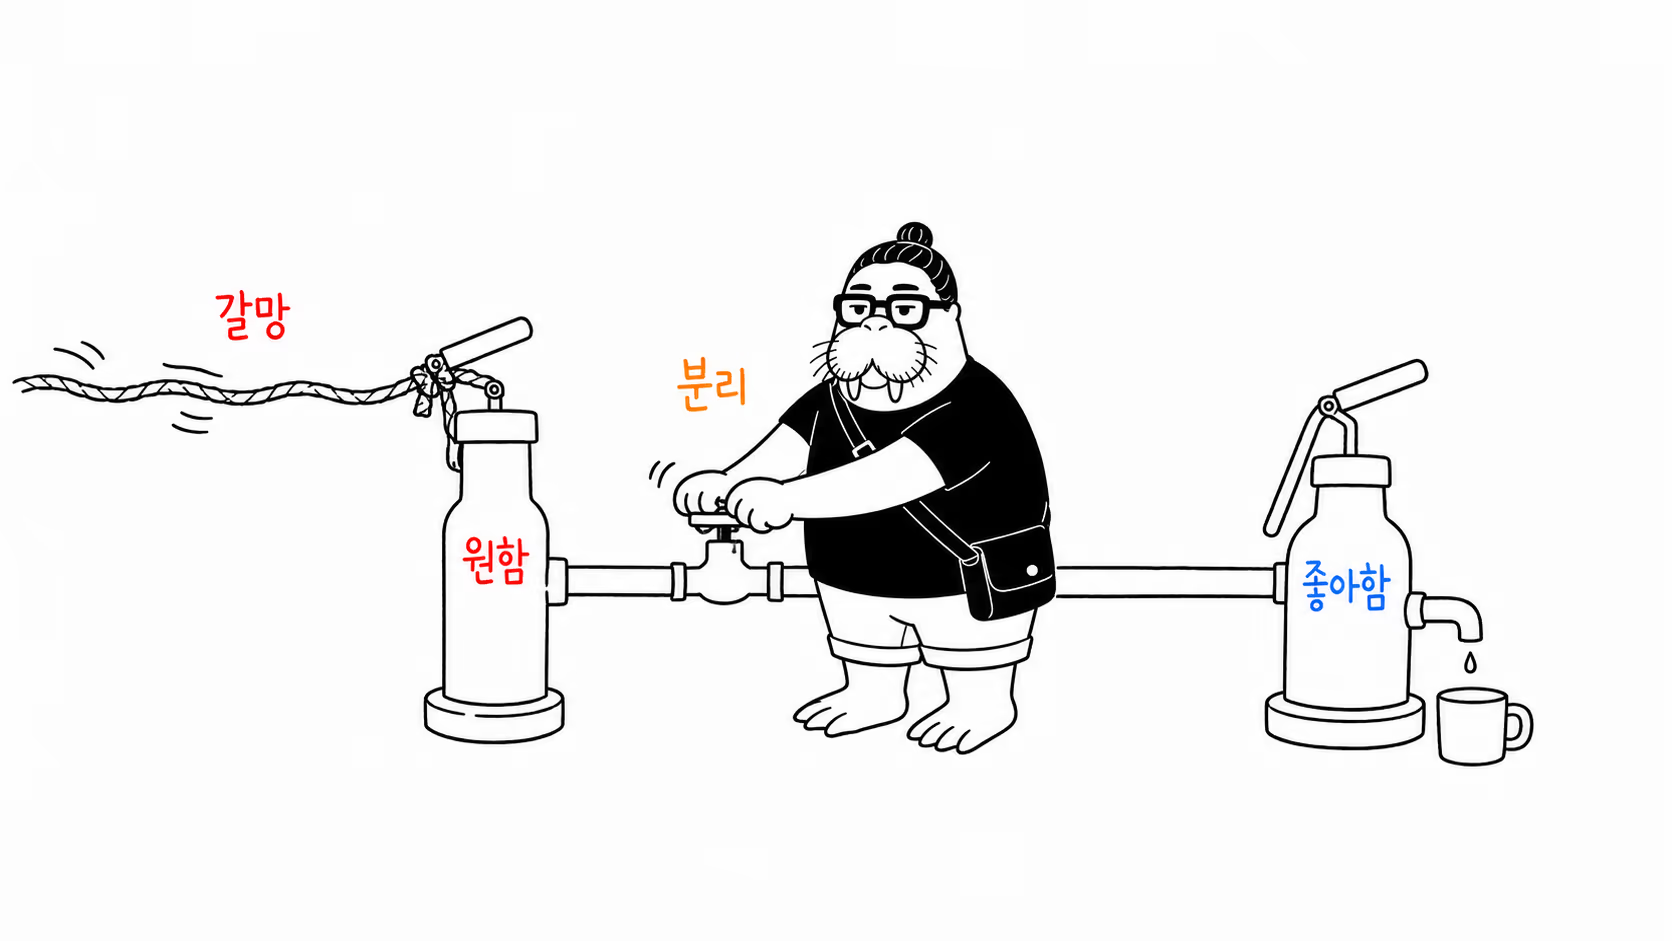
미시간대의 켄트 베리지(Kent Berridge)와 테리 로빈슨(Terry Robinson)은 여기서 한 걸음 더 나아갔다. 이들은 우리가 뭉뚱그려 쓰는 '보상'이라는 말 속에 서로 다른 두 심리가 숨어 있다고 보았다. 하나는 원함(wanting), 즉 무언가를 향해 끌려가는 갈망이고, 다른 하나는 좋아함(liking), 실제로 그것을 누릴 때의 쾌감이다.
상식적으로는 둘이 붙어 다닐 것 같다. 원하니까 좋고, 좋으니까 원한다. 그러나 쥐 실험은 이 둘을 깔끔하게 분리해냈다. 도파민을 차단당한 쥐는 설탕을 향해 다가가려는 동기, 즉 '원함'을 잃었다. 하지만 입에 직접 설탕을 넣어주면 여전히 만족스러운 표정을 지었다 — '좋아함'은 멀쩡했다. 반대로 도파민을 과도하게 자극하면 원함은 폭발했지만 좋아함은 그만큼 커지지 않았다.
도파민이 만드는 것은 쾌락이 아니라 갈망이다. 좋아함은 뇌의 훨씬 작고 연약한 회로가, 도파민이 아닌 다른 신경전달물질로 담당한다.
베리지가 '유인 민감화 이론(incentive-sensitization theory)'이라 부른 이 관점은 중독의 가장 잔인한 아이러니를 설명한다. 약물을 반복하면 '원함'을 담당하는 도파민 회로는 점점 예민해진다(민감화). 반면 '좋아함'은 오히려 무뎌진다. 그래서 중독이 깊어질수록 사람은 점점 더 강렬하게 갈망하면서도 점점 덜 즐기게 된다. 담배를 피우는 사람 대부분이 담배가 더는 즐겁지 않다고 말하면서도 끊지 못하는 이유가 여기 있다. 원함과 좋아함이 갈라선 것이다.
중독은 납치된 학습 시스템이다
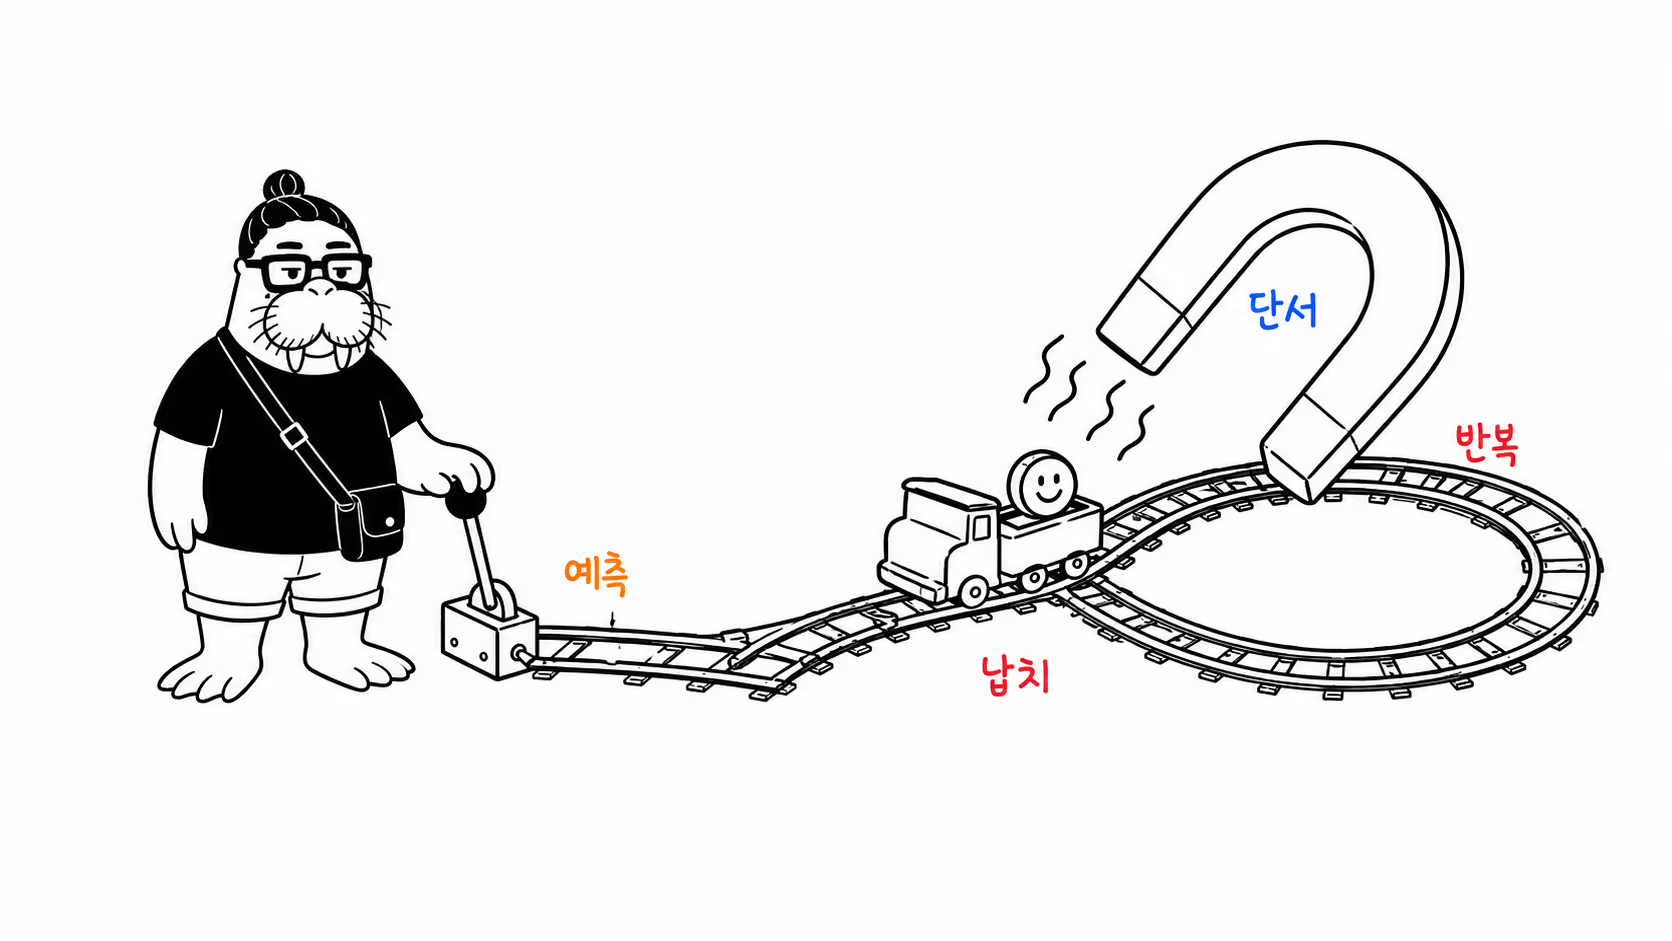
이제 그림이 맞춰진다. 코카인이나 오피오이드 같은 약물은 정상적인 보상으로는 결코 도달할 수 없는 초생리적 도파민 폭발을 뇌의 측좌핵에 일으킨다. 문제는 도파민이 학습 신호라는 데 있다. 이 거대한 '예측 오차'는 뇌에게 이렇게 가르친다. "방금 그것은 네 예상을 압도적으로 뛰어넘는 사건이었다. 무슨 수를 써서라도 다시 만들어라."
미국 국립약물남용연구소(NIDA) 소장 노라 볼코우(Nora Volkow)의 뇌영상 연구는 여기에 반전을 더한다. 중독자의 뇌를 스캔해보니, 약물이 일으키는 도파민 반응은 건강한 사람보다 오히려 둔해져 있었다. D2 수용체가 줄어들어 뇌가 도파민에 무뎌진 것이다. 슐츠의 언어로 옮기면, 중독된 뇌는 이미 초고도로 높아진 예측 기준선을 갖게 되어, 오직 약물만이 그 기준을 넘는 양의 오차를 만들 수 있다. 커피 한 잔, 친구와의 대화, 노을 같은 평범한 보상은 그 높은 기준 앞에서 아무런 신호도 만들지 못한다. 세상이 회색으로 바래는 것이다.
그래서 학습된 것은 약물의 쾌감이 아니라, 약물을 예고하는 단서들이다. 특정 골목, 특정 시간, 함께 마시던 친구의 얼굴. 도파민이 이 단서들에 달라붙은 탓에, 회복 중인 사람이 몇 년 만에 그 골목을 지나기만 해도 갈망이 되살아난다.
중독은 뇌가 고장 난 상태가 아니다. 오히려 뇌가 자기 일을 지나치게 잘 해낸 상태다.
중독은 의지가 약해서가 아니라, 학습 시스템이 너무 정확하게 일한 결과다. 이것이 '의지박약'이라는 오래된 낙인이 왜 과학적으로 빗나갔는지를 말해준다. 문제는 마음의 근육이 부실한 것이 아니라, 학습의 회로가 특정 단서에 인질로 잡힌 것이다.
쥐 공원이 던진 질문, 그리고 그 한계
그렇다면 뇌 회로가 전부인가. 1970년대 후반, 캐나다 사이먼프레이저대의 심리학자 브루스 알렉산더(Bruce K. Alexander)는 도발적인 반문을 던졌다. 그때까지 중독 연구의 표준은 좁은 철창에 홀로 갇힌 쥐에게 모르핀 물을 주는 것이었고, 쥐들은 죽을 때까지 그 물을 마셔댔다. 알렉산더는 물었다. 저 쥐가 약에 중독된 걸까, 아니면 삶에 중독될 것이 그것밖에 없는 걸까.
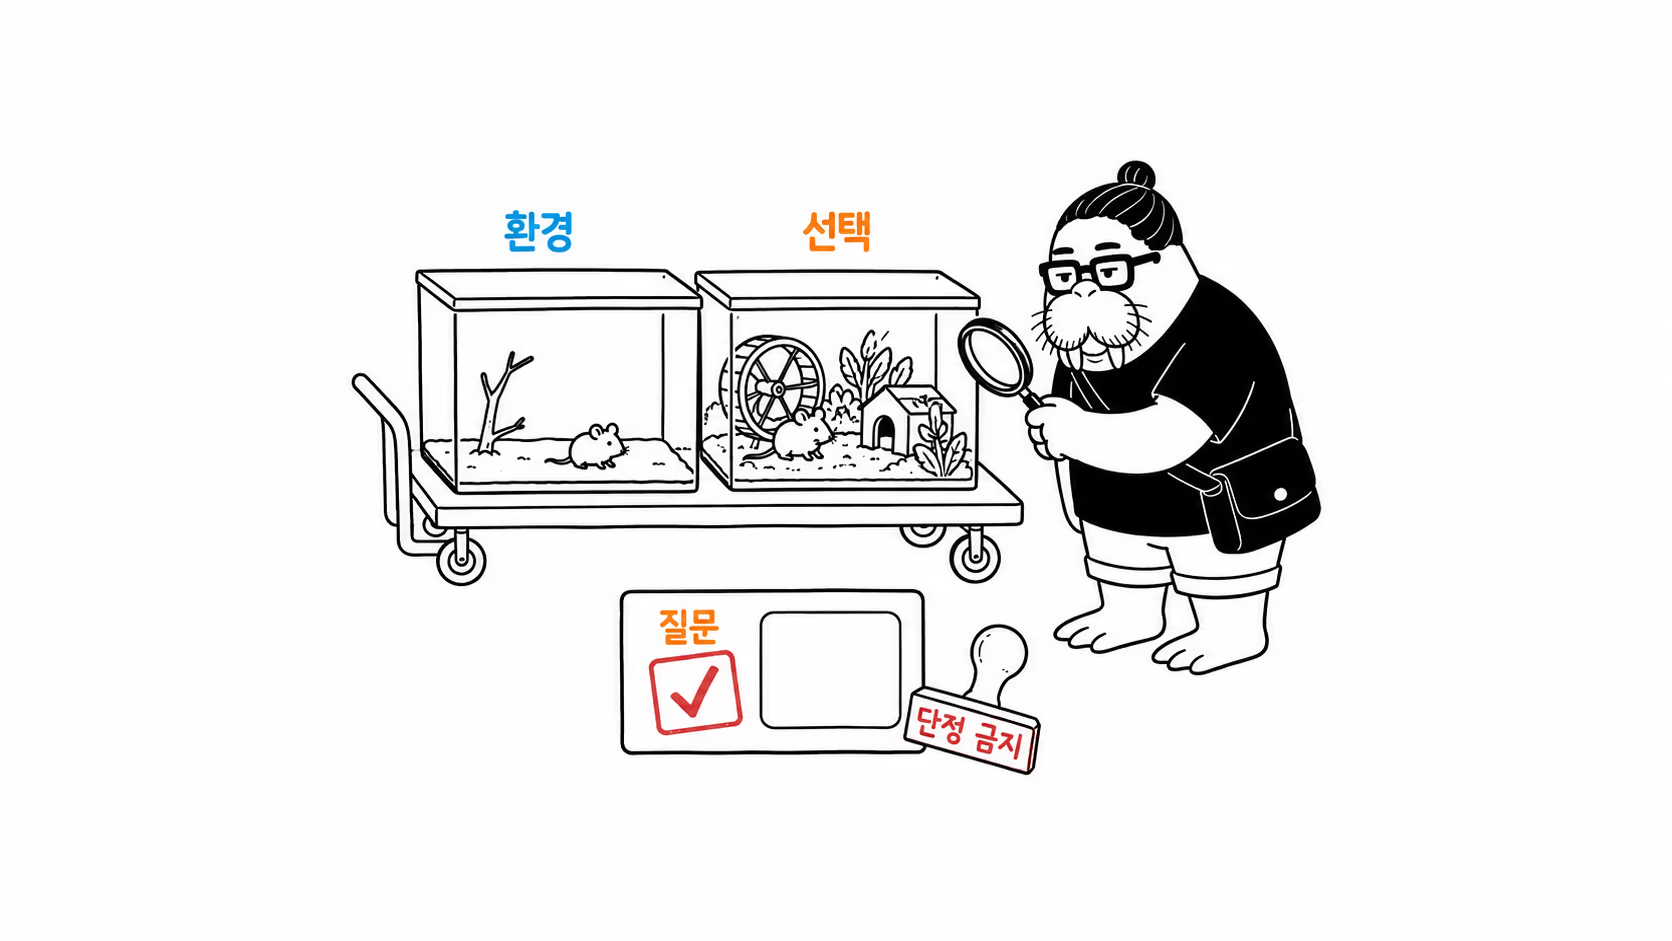
그는 '쥐 공원(Rat Park)'을 지었다. 넓고, 놀거리가 있고, 다른 쥐들과 어울리고 교미할 수 있는 낙원. 1978년에서 1981년 사이 발표된 결과에 따르면, 이 풍요로운 환경의 쥐들은 고립된 쥐들보다 모르핀 물을 훨씬 덜 마셨다 — 어떤 조건에서는 격차가 수 배에서 십수 배에 달했다. 중독은 약물의 화학이 아니라 삶의 조건이 만든다는, 강력한 메시지였다.
이 이야기는 너무 매력적이어서 널리 인용되지만, 정직하게 덧붙여야 할 것이 있다. 쥐 공원은 직접 재현에 성공하지 못했다. 1996년 한 재현 시도는 알렉산더가 쓴 것과 같은 품종의 쥐까지 맞췄지만 원래의 극적인 차이를 얻지 못했다. 표본이 적었고, 데이터 손실과 장비 문제도 있었다. 다만 '환경의 풍요로움이 약물 소비를 줄인다'는 큰 방향은 이후의 여러 연구에서 개념적으로 뒷받침되었다. 쥐 공원은 결정적 증명이 아니라, 던진 질문 자체로 값진 실험이다. 맥락은 분명 중요하다. 그러나 슬로건처럼 "중독의 반대는 연결"이라고 단정하기 전에, 우리는 이 실험이 얼마나 미끄러운 땅 위에 서 있는지도 알아야 한다.
스마트폰과 '도파민 디톡스'의 함정
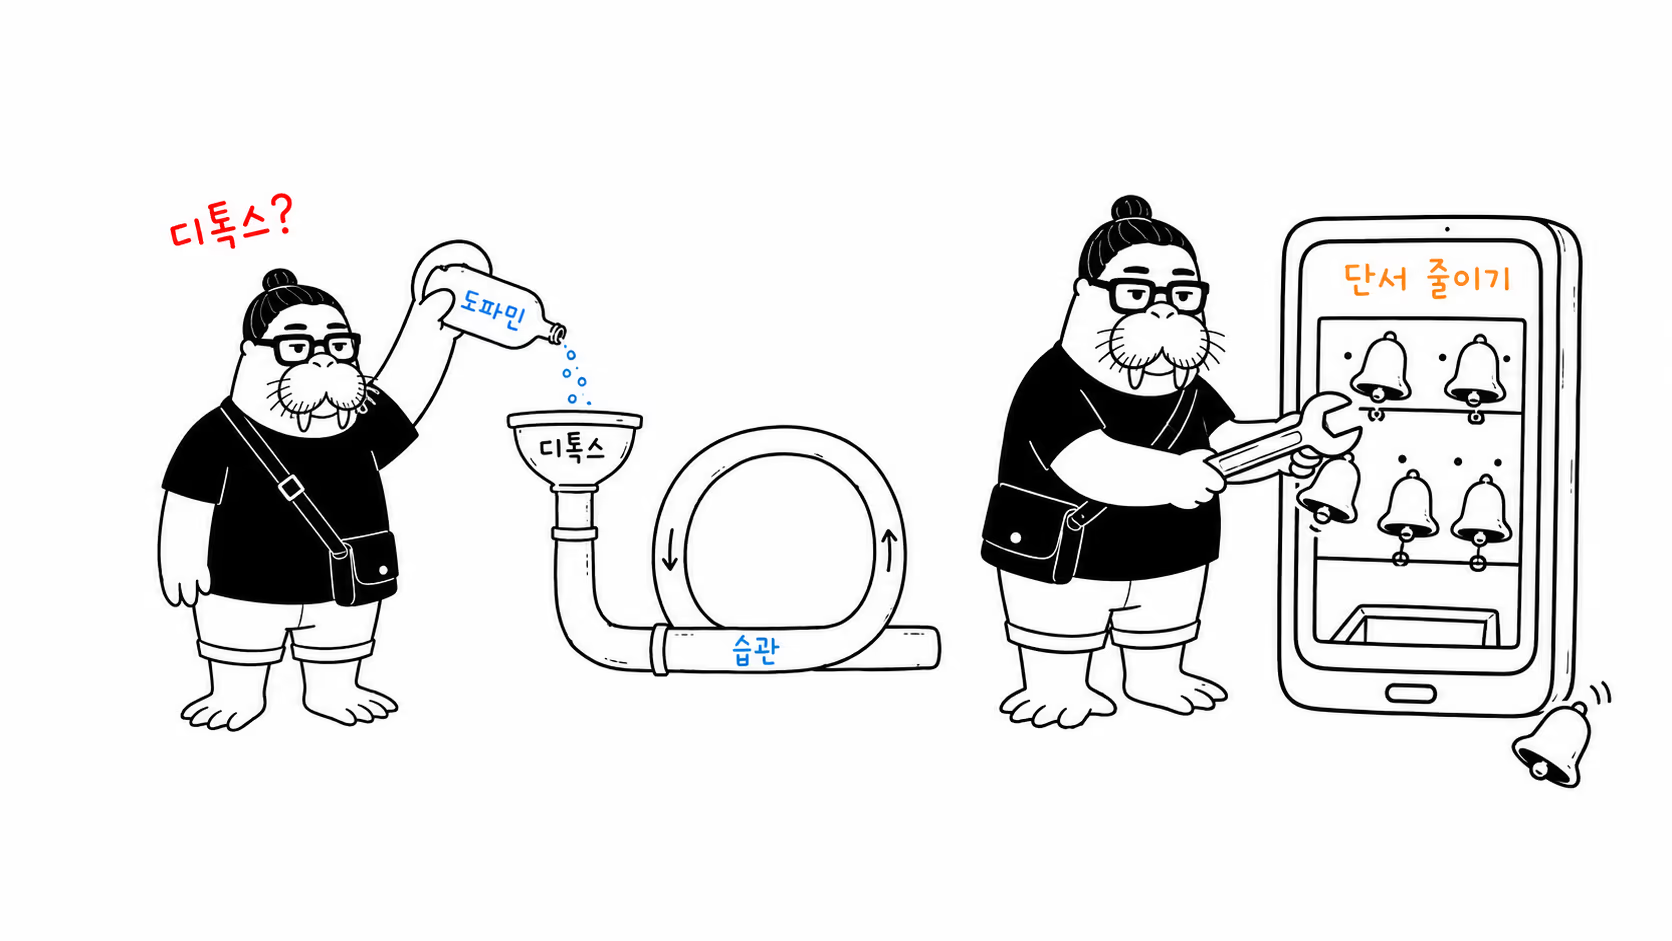
최근 몇 년, 도파민은 엉뚱한 방식으로 유명해졌다. '도파민 디톡스'라는 유행어와 함께다. 스마트폰과 SNS가 우리 뇌를 도파민으로 과부하시켰으니, 하루쯤 모든 자극을 끊어 도파민을 '리셋'하자는 주장이다. 정신과 의사 애나 렘키(Anna Lembke)가 『도파민네이션』에서 대중화한 쾌락-고통 저울의 비유가 여기 얹히면서 설득력을 얻었다.
여기서도 통념을 걷어내야 한다. 신경과학적으로 '도파민을 디톡스한다'는 말은 성립하지 않는다. 도파민은 몸에 쌓이는 독소가 아니라 매 순간 뇌가 만들어 쓰는 신호다. 굶긴다고 빠지거나 며칠 끊는다고 리셋되는 연료가 아니다. 하루 자극을 끊어 기분이 나아진다면 그것은 도파민 수치가 초기화돼서가 아니라, 강박적으로 하던 행동에서 잠시 거리를 둔 행동상의 변화 덕분이다. 이름이 틀렸다고 실천까지 무의미한 건 아니지만, 가짜 신경과학으로 포장할 이유는 없다.
더 깊은 논쟁은 스마트폰과 게임이 애초에 '중독'인가에 있다. 현재 정신의학 진단체계에서 행동중독으로 공식 인정된 것은 도박장애가 유일하다. 2013년 DSM-5는 도박장애를 충동조절장애에서 물질관련·중독장애 범주로 옮겼고, 인터넷게임장애는 '추가 연구가 필요한 상태'로만 실었다. 세계보건기구가 ICD-11에 게임장애를 넣자, 상당수 학자들은 공개 반박문을 통해 근거가 빈약하고 정상적으로 게임하는 수많은 아이들을 낙인찍을 수 있다고 경고했다. 스마트폰 중독은 아직 공식 진단명조차 아니다.
그래서, 우리는 무엇에 배우고 있나
도파민에서 쾌락이라는 착각을 걷어내면, 중독의 풍경이 달라진다. 그것은 약한 의지가 무너진 자리가 아니라, 뇌라는 뛰어난 학습 기계가 잘못된 것을 너무 잘 배워버린 자리다. 도파민은 우리에게 기쁨을 주지 않는다. 무엇을 좇을지를 가르칠 뿐이다.
이 관점은 위로이자 경고다. 위로인 것은, 중독이 인격의 결함이 아니라 시스템의 납치임을 알려주기 때문이다. 경고인 것은, 그 학습 기계가 지금 이 순간에도 당신의 주머니 속 화면 앞에서 무언가를 열심히 배우고 있기 때문이다. 매끄러운 알림음, 아래로 당기면 새로고침되는 피드, 언제 올지 모를 좋아요. 원숭이 앞의 불빛과 그리 다르지 않은 단서들이다.
질문은 남는다. 당신의 도파민은 지금, 무엇이 다음에 올지를 배우고 있는가.